Das meiste, was ein Modell schreibt, ist Markdown: der Bericht am Ende eines Agentenlaufs, die
Zusammenfassung eines Support-Verlaufs, Release Notes aus Commits. Vieles, was Menschen in ein
Notizfeld tippen, ebenso. Daraus ein PDF zu machen, sieht nach drei Schritten aus: parsen, in HTML
einpacken, mit Headless Chromium drucken. Seit dem 10. November nimmt die API von Formfeed Markdown
als eigene Quelle: POST /v1/renders mit markdown statt eines Templates, html oder einer url.
Bevor wir diese drei Schritte geschrieben haben, haben wir sie gemessen, denn der Text kommt von jemand anderem: von einem Modell, einem Kunden, von jedem, der einen API-Key hat. Drei Befunde haben entschieden, was wir gebaut haben: das HTML, das Markdown enthalten darf, die Zeit, die ein Parser für Text braucht, der langsam sein soll, und was PDF/UA-1 zu der Art sagt, wie Modelle Überschriften schreiben.
Markdown darf HTML enthalten
CommonMark reicht HTML unverändert weiter, als Block oder als Tag mitten im Satz. In Ihrer eigenen
README ist das ein Feature: ein gestalteter Kasten, ein Bild mit einer Breite. In der Antwort eines
Modells oder den Notizen eines Kunden heißt es, dass ein <script>, ein <img onerror>, ein
<iframe> oder ein <style> den Browser erreicht, der das Dokument druckt. Unverändert
weitergereicht, ließ <style>body{display:none}</style> allein eine Seite ohne etwas zum Taggen
zurück, und die PDF/UA-1-Prüfung lehnte sie ab.
Es gibt zwei übliche Antworten. Die eine: das HTML weiterreichen und dem Text vertrauen, was für Text richtig ist, den Sie selbst geschrieben haben. Die andere ist ein Sanitizer: das HTML ein zweites Mal parsen und behalten, was eine Allow-Liste nennt. Das funktioniert, aber es ist ein zweiter Parser, der HTML genauso lesen muss wie der Browser, und was er entfernt, verschwindet wortlos.
Wir haben eine dritte gewählt: zeigen. Standardmäßig (settings.markdown.html: "safe") schreibt der
Konverter rohes HTML als Text, einen Block davon in einer kleinen grauen Monospace-Schrift, ein Tag
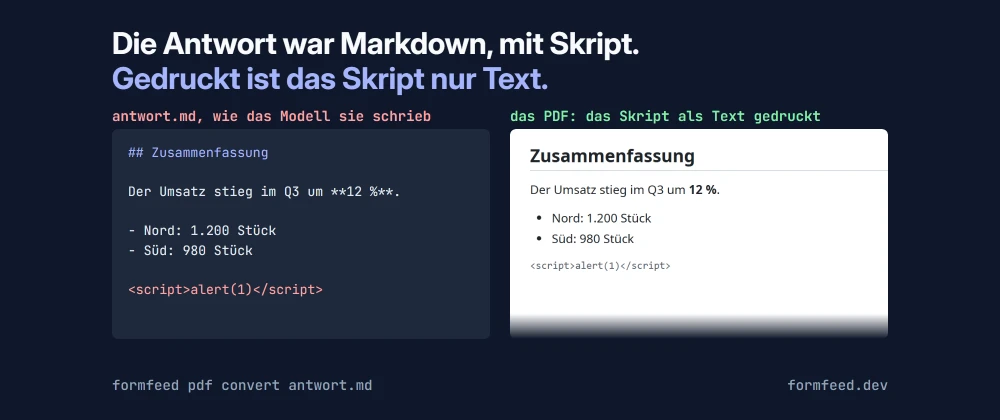
im Satz in dessen eigener Schrift. Das Titelbild dieses Beitrags ist genau dieser Fall: Das
<script>alert(1)</script> des Modells wird als diese Zeichen gedruckt, und nichts lief. Tag bleibt
nur eine kurze Liste, ohne jedes Attribut: <br>, weil eine Tabellenzelle es für eine zweite Zeile
braucht und Modelle es schreiben, und <sup>, <sub>, <kbd>, <mark>, <u>, <ins>, <del>,
<s> und <small>. Links behalten http, https, mailto, tel, relative Adressen und
#Anker; ein javascript:-Link bleibt der Text, der geschrieben wurde. Bilder behalten http,
https, Namen aus der Dateibibliothek des Workspace und data:image/ in PNG, JPEG, GIF, WebP und
SVG.
Die Frage ist also nie, ob ein Sanitizer ein Tag so gelesen hat wie Chromium: Der Konverter schreibt
kein Tag außerhalb dieser Liste. Ein Property-Test hält ihn daran, über erzeugtes Markdown gemischt
mit HTML: Was safe schreibt, enthält nie ein anderes Tag, ein on…-Attribut oder ein Link-Schema
außerhalb der Listen. Für Markdown, das Sie selbst geschrieben haben, schreibt "html": "allow"
rohes HTML unverändert, wie ein html-Rendering es tut.
Der Parser war der langsame Teil
Für Fließtext ist jeder Parser schnell: 1 MB davon, das sind 735 gedruckte Seiten, brauchte in jedem, den wir probiert haben, 0,2 bis 0,4 Sekunden, auf einer CPU der Art, auf der unser Render-Worker läuft. Text, der langsam sein soll, ist etwas anderes, und wer einen API-Key hat, kann ihn mit Absicht schicken. Wir haben jede Eingabe in einem eigenen Prozess gemessen und ihr 20 Sekunden gegeben:
| Eingabe | marked 18.0.11 | marked 18.1.3 | markdown-it 15.0.3 |
|---|---|---|---|
nicht geschlossenes *a , wiederholt |
4,7 bis 6,7 s bei 20 kB | 0,33 bis 0,42 s bei 1 MB | 0,9 bis 1,1 s bei 1 MB |
*a**b***c _d__e___f, wiederholt |
5,1 s bei 100 kB, über 20 s bei 1 MB | 4,2 bis 4,5 s bei 100 kB, über 20 s bei 1 MB | 1,25 bis 1,4 s bei 1 MB |
| 10.000 verschachtelte Zitate (20 kB) | Stack Overflow | Stack Overflow | 2 bis 29 ms |
| 1.500 verschachtelte Listenebenen | der Node-Prozess brach ab | über 20 s | 11 bis 31 ms |
marked 18.0.11 war bis zu diesem Release der Parser unseres eigenen markdown-Helpers, die erste
Zeile betraf also auch uns: Ein Template-Wert aus 20 kB nicht geschlossener Hervorhebung hätte ein
Rendering sekundenlang aufgehalten. Die folgenden Releases von marked haben die nicht geschlossenen
Begrenzer behoben, gemischte Hervorhebung und tiefe Verschachtelung nicht. markdown-it wuchs bei
jeder Eingabe, die wir ihm gaben, linear und verschachtelt höchstens 100 Ebenen tief, lief also nie
in einen Stack Overflow. Es liest die Markdown-Quelle und seit diesem Release auch den Helper, die
Engine hat also einen Parser.
Linear heißt nicht schnell. Die langsamsten Eingaben brauchten auch mit markdown-it bei 1 MB bis zu
1,9 Sekunden auf dieser einen CPU, und ein Render-Worker bedient auf derselben Event Loop andere
Renderings. Deshalb wird der Text in einem Worker-Thread umgewandelt, einem pro Render-Slot, und der
Worker beendet den Thread, sobald das Zeitlimit der Engine von 5 Sekunden verstrichen ist; das
Rendering antwortet dann mit 504 render_timeout, wie ein Template, das zu lange läuft. Der Test
dafür wandelt ein Megabyte [, eine der langsamsten Eingaben, mit einem kurzen Limit um, während ein
10-ms-Timer des Haupt-Threads pünktlich weiterläuft, und der Slot wandelt das nächste Dokument um,
als wäre nichts gewesen. In den Tests der Engine muss jede von 36 langsamen Eingaben bei 1 MB in
5 Sekunden CPU-Zeit umgewandelt sein.
Der Text selbst ist auf 1 MB UTF-8 begrenzt. So viel Fließtext brauchte auf dieser CPU vom Text bis zum PDF 5,5 Sekunden; 2 MB brauchten 26 Sekunden für 1.469 Seiten, und Chromium gibt irgendwo um 1.700 Seiten von selbst auf.
Was PDF/UA-1 zu Markdown sagt
Wir haben einen Korpus aus zwölf Dokumenten gegen veraPDF geprüft: den Bericht eines Modells, eine README mit Bildern und rohem HTML, einen deutschen Brief, eine Tabelle mit 200 Zeilen, Aufgabenlisten, Fußnoten, japanischen, chinesischen und koreanischen Text, Seitenumbrüche, die HTML-Payloads von oben und Inhalt, der breiter ist als die Seite. Als PDF/A-2b und PDF/A-3b waren alle zwölf schon bei der ersten Umwandlung gültig, mit farbigen Emoji, CJK, SVG und Transparenz. Gegen PDF/UA-1 fielen drei der zwölf durch, und die Gründe waren zwei Gewohnheiten von Markdown, nicht des Konverters.
Modelle beginnen bei ##. Eine Antwort beginnt selten mit einem #-Titel. Sie fängt bei ##
an und geht bis #### hinunter, wo eine Liste eine Überschrift braucht. PDF/UA-1 verlangt, dass die
erste Überschrift ein h1 ist und auf dem Weg nach unten keine Ebene übersprungen wird (Regel
7.4.2-1 von veraPDF); der Brief mit seinem einzigen ## und die Antwort, die von ## zu ####
sprang, fielen durch. Der Konverter schließt die Ebenen jetzt in der Struktur des Dokuments auf, die
erste Überschrift ist also ein h1 und keine liegt mehr als eine Ebene unter der, unter der sie
steht, und er behält die Größe, die der Autor geschrieben hat, über eine Klasse. Die
## Zusammenfassung auf dem Titelbild ist in der Struktur des PDFs ein h1 und sieht weiter aus wie
eine Überschrift zweiter Ebene.
Leere Tabellenzellen. Chromium schreibt für ein leeres td keine Zelle in die Struktur des PDFs,
seine Zeile ist also kürzer als die anderen, und das verletzt Regel 7.2-43; die Tabelle mit 200
Zeilen, 172 davon mit einer leeren Zelle, tat das. Der Konverter setzt ein geschütztes Leerzeichen in
eine leere Zelle, und die Zeile behält ihre Zelle.
Beide Regeln gelten für jedes Markdown-Rendering, ob es PDF/UA-1 verlangt oder nicht, damit ein
Dokument nicht anders aussieht, sobald die Prüfung eingeschaltet wird. Mit ihnen bestehen die zwölf
Dokumente in allen vier Varianten, 48 von 48: PDF/UA-1 strikt, PDF/A-2b, PDF/A-3b und PDF/UA-1
zusammen mit PDF/A-3b in einer Datei. In der Produktion bestand ein Markdown-Rendering mit beidem 106
der PDF/UA-1-Regeln von veraPDF, verletzte keine und ist ein PDF/A-3b. Das sagt, welche maschinell
prüfbaren Regeln die Datei bestanden hat; barrierefrei macht es ein Dokument nicht. Alternativtexte
schreibt weiter der Autor, in ![…].
So schicken Sie es
curl -X POST https://api.formfeed.dev/v1/renders \
  -H "Authorization: Bearer $FORMFEED_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "markdown": "## Zusammenfassung\n\nDer Umsatz stieg im Q3 um **12 %**.",
    "settings": { "locale": "de-DE", "pdf": { "outline": true, "ua": true } }
  }'
Das Theme document setzt den Text ohne eine Zeile CSS und nimmt die Schriften und die Farbe des
Brand Kits, wo die Organisation eines hat. Front Matter füllt Titel und Autor des PDFs, eine Zeile
\newpage bricht die Seite um, Fußnoten werden am Ende nummeriert. Mit einer engine ist der Text
zuerst ein Template über data. Im Terminal schickt formfeed pdf convert notizen.md die Bilder aus
dem Ordner der Datei mit; ein Agent hat das MCP-Tool markdown_to_pdf. Jeder Plan rendert Markdown,
zu den Units jedes PDFs.
Die Markdown-Anleitung nennt jede Einstellung und jedes Limit, der Anwendungsfall zeigt einen Bericht, aus Markdown gerendert, mit dem Befehl, der ihn gemacht hat, und die Guides enthalten den Aufruf als vollständiges Programm in acht Sprachen.