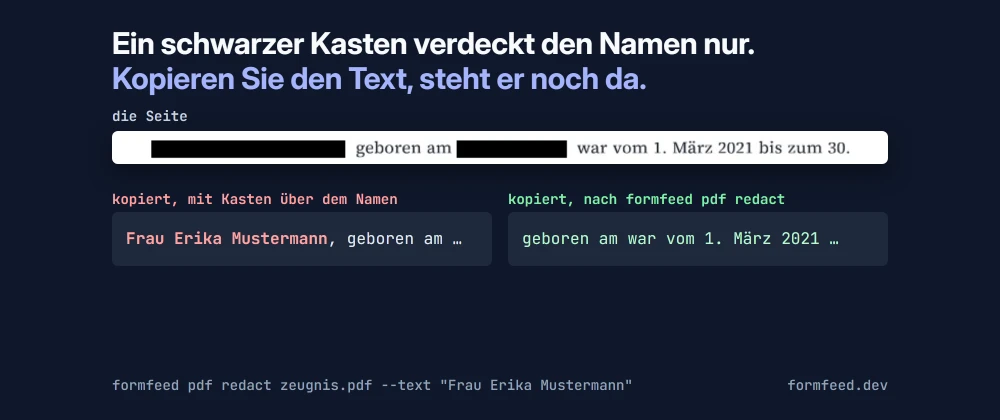
Ein schwarzer Kasten über einem Namen sieht endgültig aus. In einem PDF ist er oft nicht mehr als ein Rechteck, das über den Text gezeichnet wurde. Der Text steht weiter in der Datei, in der Reihenfolge, in der ein Viewer ihn liest, und wer die Zeile markiert und in einen Editor kopiert, hat ihn wieder.
Das ist kein Anfängerfehler aus der Frühzeit des PDF. Es passiert immer wieder Leuten, deren Aufgabe es ist, es richtig zu machen.
Dreimal kam der Text zurück
Dezember 2025. Unter den Dokumenten, die das US-Justizministerium im Dezember veröffentlichte, waren auch solche aus einer Zivilklage gegen die Testamentsvollstrecker von Jeffrey Epsteins Nachlass, 2021 auf den Amerikanischen Jungferninseln eingereicht. Laut The New York Times waren einige davon digital nicht ordentlich geschwärzt: Geschwärzter Text ließ sich lesen, indem man ihn in eine andere Datei kopierte. Ein Sprecher des Ministeriums sagte, die misslungenen Schwärzungen hätten die Parteien des Zivilverfahrens angebracht, das Ministerium habe die Unterlagen nur wiedergegeben (The New York Times, nachgedruckt bei GV Wire).
Januar 2019. Die Anwälte von Paul Manafort reichten eine Erwiderung auf den Vorwurf des Sonderermittlers ein, er habe gelogen, nachdem er sich schuldig bekannt hatte. Die Nachrichtenagentur AP konnte Passagen daraus lesen, weil sie nicht ordentlich geschwärzt waren. Demnach warf die Anklage Manafort vor, über die Weitergabe von Umfragedaten aus dem Wahlkampf 2016 an Konstantin Kilimnik gelogen zu haben, einen Geschäftspartner, dem Verbindungen zum russischen Geheimdienst vorgeworfen werden. Die Anwälte reichten später eine korrigierte Fassung ein (AP, nachgedruckt bei GBH).
Mai 2005. Das US-Militär veröffentlichte seinen Bericht über die Erschießung des italienischen Geheimdienstoffiziers Nicola Calipari im Irak als PDF mit großen geschwärzten Teilen. Kopierte man das Dokument in eine Textverarbeitung, lag der ganze Bericht offen, die Namen der beteiligten Soldaten eingeschlossen (The Register).
Zwanzig Jahre auseinander, jedes Mal dasselbe: Ein Kasten wurde gezeichnet, und der Text darunter blieb.
Was eine Schwärzung entfernen muss
Die Wörter von der Seite zu nehmen ist der erste Teil. Ein PDF hält Text an mehr Stellen als auf der Seite, und eine Schwärzung, die eine davon übersieht, hat nichts entfernt:
- Die Seite selbst. Die Zeichen unter dem Kasten müssen den Inhalt der Seite verlassen, nicht nur aus dem Blick verschwinden. Für ein Bild gilt dasselbe: Seine Pixel unter dem Kasten müssen sich ändern.
- Kopien an anderer Stelle der Datei. Der Titel und die übrigen Metadaten des Dokuments, seine Lesezeichen, die Werte seiner Formularfelder, Kommentare und ihre Pop-ups, die Adresse eines Links und angehängte Dateien. Ein getaggtes PDF kann außerdem die Wörter tragen, die ein Screenreader statt des Seitentexts vorliest, einen ActualText, also eine zweite Kopie derselben Wörter.
- Frühere Fassungen. Ein PDF lässt sich speichern, indem die Änderungen ans Ende der Datei angehängt werden, und die Fassung vor der Änderung bleibt darin, mit dem richtigen Werkzeug lesbar.
- Text, der ein Bild ist. Eine gescannte Seite enthält ein Foto der Wörter, oft mit einer unsichtbaren Textebene aus der Texterkennung des Scanners darüber. Beides muss weg.
Wie Formfeed schwärzt
Die PDF-Tools von Formfeed schwärzen ein PDF nach Rechtecken der Seite oder nach den Texten, die entfernt werden sollen, über die API, die Kommandozeile und den MCP-Server für KI-Agenten. Das Entfernen übernimmt litho, die PDF-Engine von Gotenberg 9, die jedes Zeichen herausnimmt, das eine Region berührt. Zwei Dinge, die wir gemessen haben, haben den Rest bestimmt:
- litho nimmt ein Zeichen an einem Kasten, der bis zur Oberlänge der Schrift reicht, sodass eine Region in Zeilenhöhe auch die Zeile darunter nahm. Ein gefundener Text wird deshalb mit einem schmalen Streifen durch die Mitte seiner Zeichen geschnitten, und der schwarze Kasten wird getrennt darüber gezeichnet.
- Am Tag, an dem die Tools in Produktion gingen, kam ein Kasten über einer Region, in der nichts zu entfernen war, als Nachtrag zur unveränderten Datei zurück: zwei Fassungen in einem PDF. Die Produktion hat diese Datei abgelehnt, und seitdem wird ein solches Ergebnis neu geschrieben, bevor irgendetwas anderes es liest.
Danach wird das Ergebnis erneut gelesen, und es wird nichts ausgeliefert, solange Text unter einem
Rechteck liegt, solange ein genannter Text oder auch nur ein Buchstabe davon noch auf einer Seite
steht, solange ein genannter Text in den Metadaten, Lesezeichen, Anhängen, dem Formular oder den
Anmerkungen steht, solange eine Kopie übrig ist, die sich nicht löschen lässt (etwa ein ActualText),
oder solange die Datei eine frühere Fassung behält. Die Antwort ist dann
422 redaction_incomplete: keine Datei,
nichts berechnet, und das Problem nennt Regionen und Texte nach ihrer Nummer, nie nach ihren Wörtern.
Die Texte selbst werden nie gespeichert oder protokolliert.
Der Buchstabe, den wir stehen ließen
„Auch nur ein Buchstabe“ stand bis diese Woche nicht in dieser Liste. Während wir jede Aussage dieses Beitrags an unseren eigenen Dateien prüften, haben wir den Text aus der geschwärzten Beispielvereinbarung auf der englischen Seite unserer PDF-Tools kopiert. Er lautete:
2. O a company registered in England and Wales under number 00000000, whose„Olvarest Ltd“ war weg, bis auf den ersten Buchstaben, der unter dem schwarzen Kasten stand. Auf der Seite war davon nichts zu sehen.
Die Ursache war eine Messung, die wir verallgemeinert hatten. Chrome hatte die Schriften der Vereinbarung als Type3-Schriften ins PDF geschrieben, und litho nimmt ein Zeichen einer Type3-Schrift nicht an seiner eigenen Breite, sondern am Begrenzungsrahmen der Schrift, an das Zeichen gesetzt. Das hatten wir an einem anderen Dokument gemessen, dessen Rahmen etwa ein Geviert reichten, und für jede solche Schrift 0,85 Geviert notiert. In der Vereinbarung reicht der Rahmen der normalen Schrift von −0,074 bis 0,995 Geviert, sodass das Leerzeichen vor dem Namen in das „O“ hineinreicht; der Rahmen der fetten Schrift endet bei 0,698 Geviert, noch bevor das „O“ selbst endet. Um das Leerzeichen zu schonen, begann der Schnitt gleich danach, drei Viertel eines Punkts hinter dem Ende des Rahmens des „O“.
Die Prüfung hat es nicht bemerkt, weil sie zwei Fragen stellte: Lässt sich der ganze Text noch finden, und steht noch ein Buchstabe unter dem Schnitt? „Olvarest Ltd“ ließ sich nicht finden, und das „O“ stand neben dem Schnitt, nicht darunter. Keine der beiden Fragen war, ob jeder Buchstabe des Texts weg ist.
Beides ist behoben. Jedes Zeichen wird jetzt am Rahmen seiner eigenen Schrift geschnitten, aus dem PDF
gelesen: Vorhergesagt waren für das „O“ 82,93 bis 90,17 Punkt, litho nahm es zwischen 83,0 und 90,0,
als wir eine schmale Region in Viertelpunkt-Schritten darüber bewegten. Wo sich ein Buchstabe nicht
schneiden lässt, ohne das Zeichen daneben zu berühren, geht dieses Zeichen mit, meist ein Leerzeichen
oder Satzzeichen. Und die Prüfung verlangt von jedem Buchstaben jeder Fundstelle, dass er weg ist, wo
immer der Schnitt verlief. Dieselbe Zeile lautet jetzt 2. , a company registered …. Keine Datei
eines Kunden war betroffen: Die einzigen Schwärzungen in Produktion waren unsere eigenen Tests.
Die Lehre ist die der drei Fälle: Schauen Sie darauf, was die Datei enthält, nicht darauf, was sie zeigt.
Ein geschwärztes PDF selbst prüfen
Dafür brauchen Sie unsere Werkzeuge nicht. Mit den Kommandozeilen-Tools von Poppler und einem Texteditor:
# der Seitentext: nichts von den entfernten Wörtern darf zurückkommen
pdftotext -layout geschwaerzt.pdf - | grep -i "mustermann"

# Titel, Autor, Thema und Stichwörter
pdfinfo geschwaerzt.pdf

# angehängte Dateien
pdfdetach -list geschwaerzt.pdf

# mehr als ein %%EOF deutet auf eine frühere Fassung in der Datei hin
# (eine für schnelle Webanzeige gespeicherte Datei hat ebenfalls zwei)
grep -ac '%%EOF' geschwaerzt.pdf
Lesezeichen, Formularfelder und Kommentare sehen Sie am besten in den Seitenleisten eines Viewers an. Und kopieren Sie die geschwärzte Zeile selbst: Kommt ein Wort zurück, kommt es für alle anderen auch zurück.
Ausprobieren
Schwärzen gibt es ab dem Starter-Plan, eine halbe Einheit pro Aufruf:
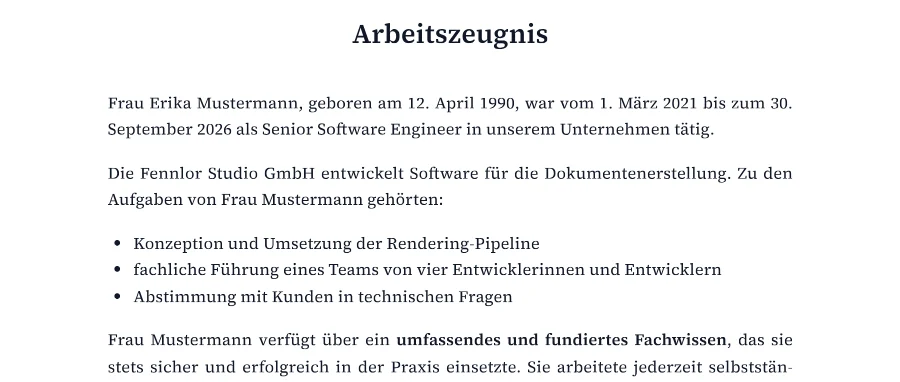
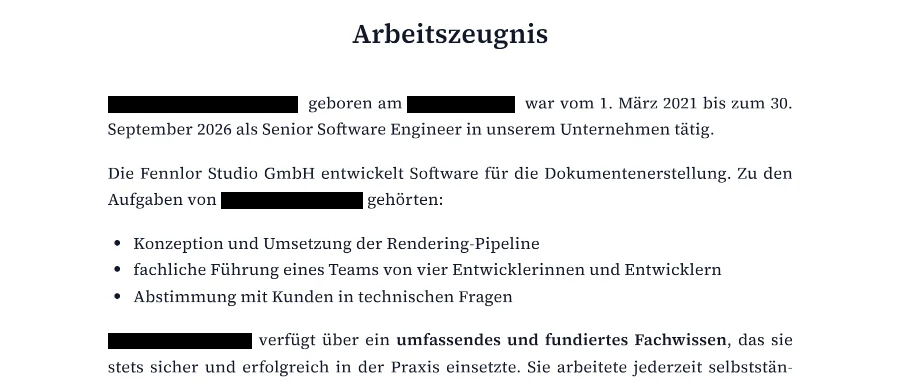
formfeed pdf redact zeugnis.pdf --text "Frau Erika Mustermann" --text "12. April 1990"Das schreibt zeugnis-redacted.pdf neben die Quelle. Ist von den Texten etwas übrig, endet der Befehl
mit Code 1 und schreibt keine Datei. Die Dokumentation
beschreibt die API, die Rechtecke und jede Prüfung.